Dans chaque organisation logicielle revient la même conversation : les développeurs demandent du temps pour « remettre le code en ordre », la direction demande des fonctionnalités et des résultats visibles. Le refactoring passe pour une activité technique, interne, difficile à justifier. On le repousse donc jusqu’à ce que le coût de l’inaction devienne impossible à ignorer.
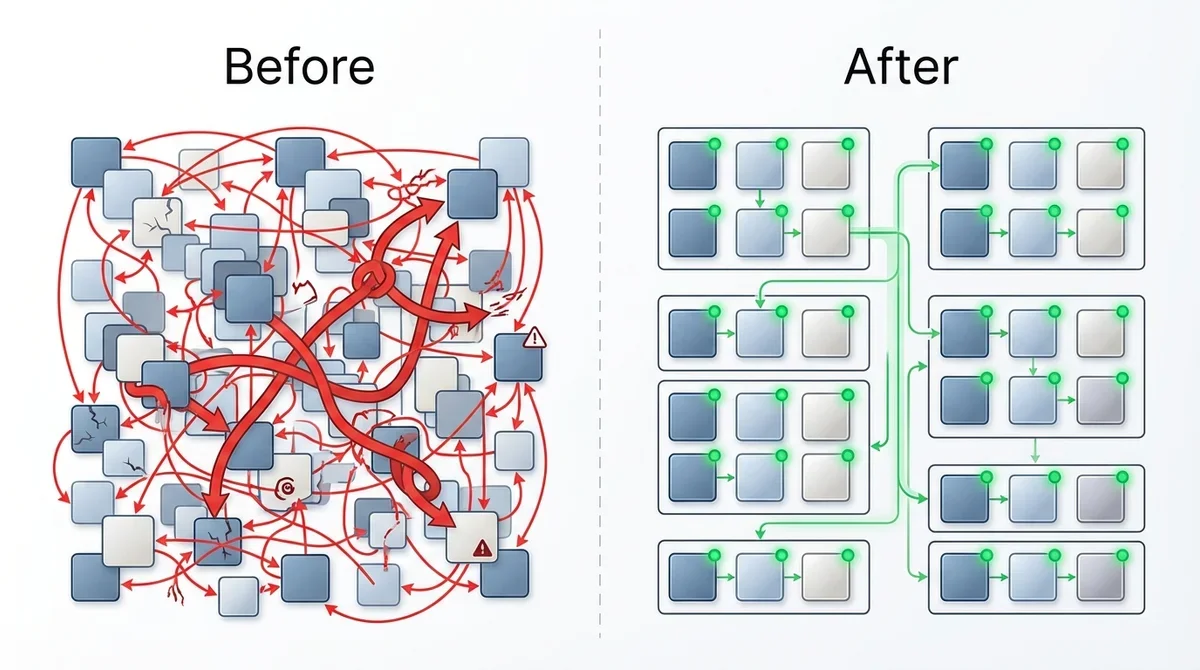
C’est là que se trouvent beaucoup d’entreprises : un système qui fonctionne, mais qui freine. Chaque nouvelle fonctionnalité prend plus de temps que prévu, chaque mise en production génère de l’anxiété, chaque nouveau développeur met des semaines à devenir productif. Le coût du changement augmente, la roadmap devient peu fiable, et la direction sent un ralentissement sans en comprendre la cause.
Le refactoring stratégique traite ce problème comme une décision business : on choisit où agir en fonction de l’impact, on chiffre le coût de l’inaction, et on mesure le retour.
Pourquoi le refactoring est toujours repoussé
Le problème est une question de langage. Quand un CTO dit « il faut faire du refactoring », le CEO entend « on veut dépenser du temps et de l’argent sans rien produire de visible ». La perception, c’est que le refactoring est un coût sans retour, un caprice technique, une demande de temps pour « arranger des choses » qui auraient dû être bien faites dès le départ.
Cette perception est fausse, mais compréhensible. La dette technique reste invisible de l’extérieur : le logiciel fonctionne, les clients l’utilisent, les fonctionnalités sortent. Le fait qu’une fonctionnalité coûte trois fois ce qu’elle devrait, ou qu’une mise en production exige trois jours de tests manuels, échappe à quiconque ne travaille pas sur le code.
Le refactoring se justifie en parlant de coûts, de risques et d’occasions manquées.
Comment chiffrer le coût de l’inaction
La dette technique a un coût. Un coût très concret, payé chaque jour en temps, en risque et en occasions manquées. Selon McKinsey, la dette technique représente en moyenne 20 à 40 % de la valeur de tout le patrimoine IT d’une entreprise avant d’être traitée.
Pour le rendre visible à la direction, il faut des chiffres concrets :
- Temps de mise en production : combien de temps s’écoule entre le moment où une fonctionnalité est prête et celui où elle arrive en production ? Si la réponse dépasse une semaine, il y a de la friction architecturale. Multiplier ce temps par le coût horaire de l’équipe donne le coût de la dette sur chaque mise en production
- Coût de coordination : combien de réunions, de revues de code croisées et de points d’alignement faut-il pour chaque changement ? Chaque heure de coordination est une heure non consacrée à produire de la valeur
- Bugs récurrents : combien d’incidents en production viennent de zones de code connues comme problématiques ? Chaque incident a un coût : temps de diagnostic, temps de correction, impact client, stress de l’équipe
- Onboarding lent : combien de temps faut-il à un nouveau développeur pour devenir productif ? Si la réponse dépasse un mois, le codebase est trop complexe. Chaque mois d’onboarding, c’est un salaire dépensé en formation, au détriment de la livraison
Le Consistency Impact Calculator aide à estimer ces coûts. Une fois les chiffres sur la table, la conversation change : on parle désormais de « réduire un coût qu’on paie tous les jours ».
Où agir : pas partout
Le refactoring stratégique consiste à choisir chirurgicalement où agir pour obtenir le maximum d’impact avec le minimum de risque.
Le critère de choix tient en une phrase : agir là où la friction est la plus forte et le changement le plus fréquent.
Un module mal écrit mais qui ne change jamais n’est pas une priorité : le coût de sa dette reste faible, car personne ne le paie. Un module qui change chaque semaine et génère des bugs à chaque modification, lui, est la priorité : le coût de sa dette se paie en continu.
Pour repérer le bon point d’entrée, trois questions :
- Quelle partie du code change le plus souvent ? (fréquence de changement)
- Quelle partie génère le plus de bugs ou demande le plus de coordination ? (friction)
- Quelle partie bloque le plus d’équipes ou ralentit le plus de mises en production ? (impact sur la livraison)
L’intersection de ces trois réponses indique le point de départ.
Comment refactorer sans arrêter la livraison
La peur la plus répandue, c’est que le refactoring arrête la production de fonctionnalités. Cette peur est fondée si l’on traite le refactoring comme un projet à part : « pendant trois mois, on ne fait pas de fonctionnalités, on répare le code ». Cette approche échoue presque à chaque fois, parce que le métier ne peut pas attendre trois mois et que l’équipe perd le contexte.
L’approche qui fonctionne, c’est le refactoring incrémental, intégré au flux de travail quotidien :
- Avant d’ajouter une fonctionnalité : améliorer la structure du module qui va l’accueillir. Le refactoring prépare le terrain ; la fonctionnalité devient plus simple à implémenter
- Pendant une modification : laisser le code dans un état meilleur qu’on ne l’a trouvé (la « boy scout rule »). De petites améliorations continues, toujours par petits pas
- Après un incident : chaque bug en production est l’occasion d’améliorer la partie de code qui l’a causé. Le correctif devient l’occasion de renforcer la structure, en plus de régler le symptôme
Cette approche produit des résultats progressifs mais constants, sans jamais interrompre la livraison. L’équipe continue de livrer des fonctionnalités pendant que le code s’améliore.
Refactoring contre réécriture : pourquoi le refactoring l’emporte
La réécriture, c’est la tentation ultime : « ce code est irrécupérable, on repart de zéro ». Comme on l’a vu dans l’article sur l’architecture évolutive, les réécritures complètes échouent à une fréquence impressionnante, parce que l’ancien système porte des années de logique métier que plus personne ne se rappelle.
Le refactoring stratégique a trois avantages décisifs sur la réécriture :
- Il est incrémental : on améliore un morceau à la fois, sans jamais tout jeter. Le risque reste contenu, car chaque pas est petit et réversible
- Il est continu : c’est une pratique permanente, sans début ni fin fixes. Le code s’améliore sans cesse, la dette ne s’accumule pas
- Il n’interrompt pas la livraison : l’équipe continue de produire de la valeur visible pendant que le système s’améliore sous la surface
La réécriture n’a de sens que dans un seul cas : quand le système est si compromis que le coût de chaque modification dépasse le coût d’une reconstruction. C’est rare ; et quand cela arrive, un refactoring stratégique mené à temps aurait souvent pu l’éviter.
Ce qu’il faut faire concrètement
Trois actions pour commencer :
Sur nos missions d’Intervention ciblée, la première question qu’on se pose, c’est « où la livraison ralentit-elle vraiment ? ». Les 20 % du code qui causent 80 % des problèmes sont presque toujours faciles à repérer : c’est la partie que tout le monde évite de toucher, celle où les pull requests traînent des jours quand elles devraient prendre des heures, celle où chaque changement produit des bugs inattendus. C’est là qu’on intervient en premier. Un refactoring concentré sur les points chauds du système fait bouger les choses ; dispersé partout, beaucoup moins.
- Chiffrez le coût actuel de la dette : mesurez le temps moyen de mise en production, le nombre de bugs récurrents, le temps d’onboarding. Mettez ces chiffres devant la direction. Les chiffres changent la conversation
- Choisissez un seul module : celui où la friction et la fréquence de changement sont les plus fortes, le plus douloureux. Sa taille ne compte pas. Définissez une intervention circonscrite avec un résultat mesurable (temps de mise en production réduit de 30 %, bugs divisés par deux, une équipe de moins impliquée)
- Intégrez le refactoring au flux, sans créer de projet séparé. Consacrez 20 % du temps de chaque sprint à améliorer la structure du code dans la zone sur laquelle vous travaillez déjà. C’est soutenable, c’est continu, et cela produit des résultats visibles en quelques semaines
Si la dette est répandue et que les frontières du système restent floues, le refactoring du code legacy travaille le code avec votre équipe, zone par zone, sans arrêter la roadmap ; si le blocage se résume à un seul point, une intervention ciblée peut identifier le point de levier et débloquer la situation. L’investissement se rembourse dès la première fonctionnalité livrée plus vite.