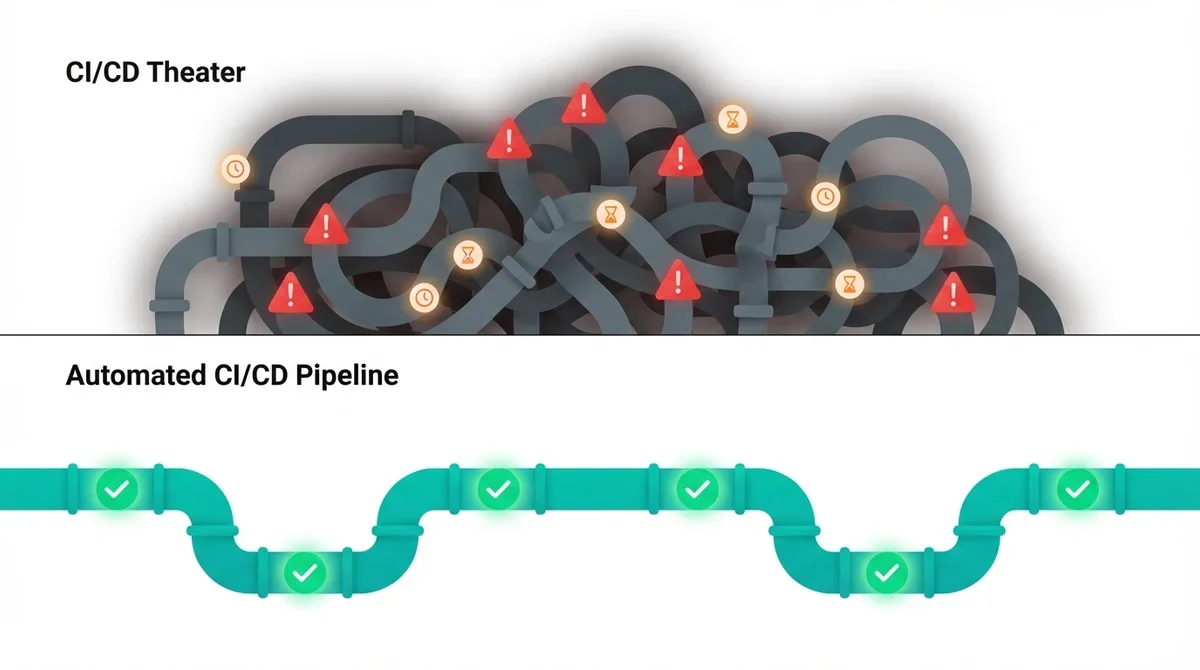
La plupart des organisations logicielles ont une pipeline CI/CD. Jenkins, GitHub Actions, GitLab CI, CircleCI : l’outil est là. Et pourtant, les mises en production restent rares, risquées et stressantes. Les branches vivent des semaines, les fusions génèrent des conflits, les tests tournent pendant des heures et échouent de façon imprévisible. Le vendredi, personne ne livre.
Avoir une pipeline ne veut pas dire faire de l’intégration continue (continuous integration), et encore moins de la livraison continue (continuous delivery). Beaucoup d’organisations ont automatisé la mise en scène : la pipeline existe, mais le processus de mise en production reste pour l’essentiel manuel, lent et fragile.
Le CI/CD n’est pas un outil à installer, c’est une pratique à adopter. Et l’écart entre qui la pratique vraiment et qui possède juste l’outil, c’est exactement l’écart entre livrer chaque jour en confiance et trembler à chaque mise en production mensuelle.
Ce qu’est vraiment l’intégration continue
L’intégration continue a une définition précise, formulée par Martin Fowler et Matthew Foemmel en 2000 et toujours valable aujourd’hui : chaque développeur intègre son code dans le trunk (la branche principale) au moins une fois par jour, et chaque intégration est vérifiée par une build automatisée avec des tests. Fowler a ensuite révisé et approfondi l’article en 2006, mais le principe fondamental remonte à l’original.
Trois mots comptent ici :
- Trunk : une seule branche partagée, où tout le monde intègre ; les branches par fonctionnalité qui vivent des semaines n’y ont pas leur place
- Au moins une fois par jour : des intégrations petites et fréquentes. Chaque commit est assez petit pour être compris, revu et vérifié en quelques minutes
- Une build automatisée avec des tests : chaque intégration déclenche une pipeline qui compile, teste et vérifie. En cas d’échec, l’équipe s’arrête et corrige avant de continuer
L’intégration continue exige des branches qui durent moins d’un jour, des tests qui tournent à chaque commit, et une build que l’équipe corrige en moins d’une heure en cas d’échec. Sans ces trois éléments, on obtient autre chose, peut-être utile, mais différent de la CI au sens de sa définition d’origine.
Le théâtre du CI/CD
Voici le schéma que nous observons le plus souvent dans les organisations en croissance :
- Chaque développeur travaille sur une branche séparée pendant des jours ou des semaines
- La fusion arrive à la fin, génère des conflits, demande des heures de résolution
- La pipeline tourne sur la branche, passe, mais une fois le code arrivé dans le trunk, les tests échouent
- Les tests end-to-end sont lents (30 à 60 minutes), fragiles, et souvent ignorés quand ils échouent
- La mise en production exige un « release manager » qui coordonne, teste manuellement et décide quand c’est sûr
- Le déploiement a lieu le jeudi matin, jamais le vendredi, jamais après 16 heures
La pipeline existe ; le processus, lui, reste manuel. L’automatisation couvre les étapes faciles (compiler, lancer les tests) mais ne traite jamais les vrais problèmes : branches de longue durée, tests peu fiables, manque de confiance dans la mise en production.
Le signal le plus clair que votre CI/CD n’est que du théâtre : l’équipe a peur de livrer. Si livrer génère de l’anxiété, le processus ne fonctionne pas, peu importe la sophistication de la pipeline.
Pourquoi l’outil n’est pas le problème
Jenkins, GitHub Actions, GitLab CI : ce sont tous des outils capables. L’écart entre une organisation qui livre chaque jour en confiance et une qui livre dans la terreur une fois par mois tient à trois facteurs, bien plus importants que l’outil choisi.
Premier facteur : la stratégie de branching. Le trunk-based development, où tout le monde travaille sur la même branche avec des intégrations fréquentes, est le préalable à une vraie CI. Les feature branches de longue durée sont l’anti-pattern le plus répandu et le plus nocif : elles retardent l’intégration, amplifient les conflits et transforment chaque fusion en événement risqué.
Deuxième facteur : la stratégie de tests. Une pipeline avec des tests lents et fragiles est pire qu’une pipeline sans tests, parce qu’elle crée un faux sentiment de sécurité. Les tests doivent être rapides (sous les 10 minutes pour la suite complète), fiables et pertinents (ils portent sur le comportement observable). Les équipes les plus matures visent zéro test flaky : chaque test instable se diagnostique et se corrige, sans jamais être exclu ou ignoré. Si la suite de tests dépasse 15 minutes, plus personne n’attendra le résultat avant d’avancer.
Troisième facteur : la culture de la mise en production. Livrer souvent réduit le risque de chaque livraison. Une mise en production qui contient un seul changement est facile à comprendre, à vérifier et, si besoin, à annuler. Une mise en production qui contient trois semaines de travail de cinq équipes est une bombe à retardement. Cette culture de la livraison fréquente se construit par la pratique : on commence par livrer deux fois par semaine, puis chaque jour, puis plusieurs fois par jour.
Comment passer de la pipeline à la livraison continue
La transition est un parcours incrémental. Chaque étape réduit le risque de la suivante.
Étape 1 : raccourcir la durée de vie des branches. Des semaines aux jours, des jours aux heures. Les feature flags permettent d’intégrer du code incomplet dans le trunk sans l’exposer aux utilisateurs : le code est en production, mais la fonctionnalité reste éteinte tant qu’elle n’est pas prête. Cela élimine le problème à la racine : il n’y a plus de branche à fusionner, puisque tout est déjà dans le trunk.
Étape 2 : rendre les tests rapides et fiables. Éliminer les tests flaky (ceux qui échouent de façon aléatoire) : chaque test flaky toléré érode la confiance dans la pipeline. Déplacer le poids des tests end-to-end (lents et fragiles) vers les tests unitaires et d’intégration (rapides et fiables). L’objectif : une suite qui tourne en moins de 10 minutes et qui, quand elle échoue, signale un vrai problème.
Étape 3 : automatiser la mise en production. Si les tests passent et que la build est verte, la mise en production devrait se résumer à un clic. Retirer les étapes manuelles une par une : d’abord le déploiement en staging devient automatique, puis le déploiement en production devient un clic, puis cela aussi devient automatique. Chaque étape manuelle retirée est un point de friction en moins.
Étape 4 : livrer petit et souvent. La fréquence de mise en production est l’indicateur le plus important. Des livraisons petites et fréquentes réduisent le risque, accélèrent le feedback et rendent le rollback trivial. Si quelque chose tourne mal sur une mise en production qui contient un seul changement, la cause saute aux yeux. Si ça tourne mal sur une mise en production qui en contient 47, bon courage pour trouver le problème.
L’impact sur l’activité
Un CI/CD réel est un avantage concurrentiel. Les organisations qui livrent chaque jour en confiance réagissent au marché en quelques heures (il leur fallait des mois auparavant) ; elles expérimentent avec des feature flags et mesurent l’impact avant d’investir davantage ; elles corrigent les problèmes en production en quelques minutes (il fallait des jours).
Les DORA metrics (deployment frequency, lead time for changes, change failure rate, time to restore) restent la façon la plus directe de mesurer l’efficacité du CI/CD. Les organisations « elite » du rapport DORA livrent plusieurs fois par jour avec un change failure rate de 5 à 15 % : un objectif atteignable, le résultat naturel des pratiques décrites dans cet article.
Ce qu’il faut faire concrètement
Trois actions à mener cette semaine :
Quand nous arrivons dans une équipe dans le cadre de nos Équipes intégrées, nous trouvons presque toujours la même situation : une pipeline configurée, mais des tests qu’on saute parce qu’« ils ne passent pas en CI », ou des branches qui vivent des semaines parce qu’« on attend d’intégrer le tout ensemble ». Le théâtre du CI/CD vient presque toujours de l’absence d’un accord partagé sur ce que signifie une build verte. La première chose que nous mettons en place, c’est ce contrat : zéro test ignoré, une build rouge veut dire stop, aucune exception. Cela paraît banal, mais cela exige que l’équipe arrête de traiter la pipeline comme un obstacle à contourner et commence à la traiter comme le thermomètre de la santé du système.
- Mesurez votre fréquence de mise en production actuelle : combien de fois l’équipe livre-t-elle en production ? Si la réponse est « moins d’une fois par semaine », il y a de la marge. Le Consistency Impact Calculator aide à estimer ce que coûte chaque jour de retard dans la mise en production
- Identifiez votre branche la plus ancienne : depuis combien de temps la branche la plus longue est-elle ouverte ? Chaque jour supplémentaire est du risque accumulé. L’objectif : qu’aucune branche ne vive plus de 24 heures
- Chronométrez votre pipeline : combien de temps s’écoule entre le commit et le retour des tests ? Au-delà de 15 minutes, les développeurs arrêteront d’attendre le résultat. L’objectif est sous les 10 minutes ; l’idéal, sous les 5
Si la pipeline est lente, les tests peu fiables et les mises en production rares, la solution consiste à changer le processus, la culture et, souvent, l’architecture qui les contraint. C’est exactement le type d’intervention que nous menons avec les Équipes intégrées : nous rejoignons l’équipe, travaillons ensemble et transférons les pratiques qui font de la livraison continue une réalité quotidienne.