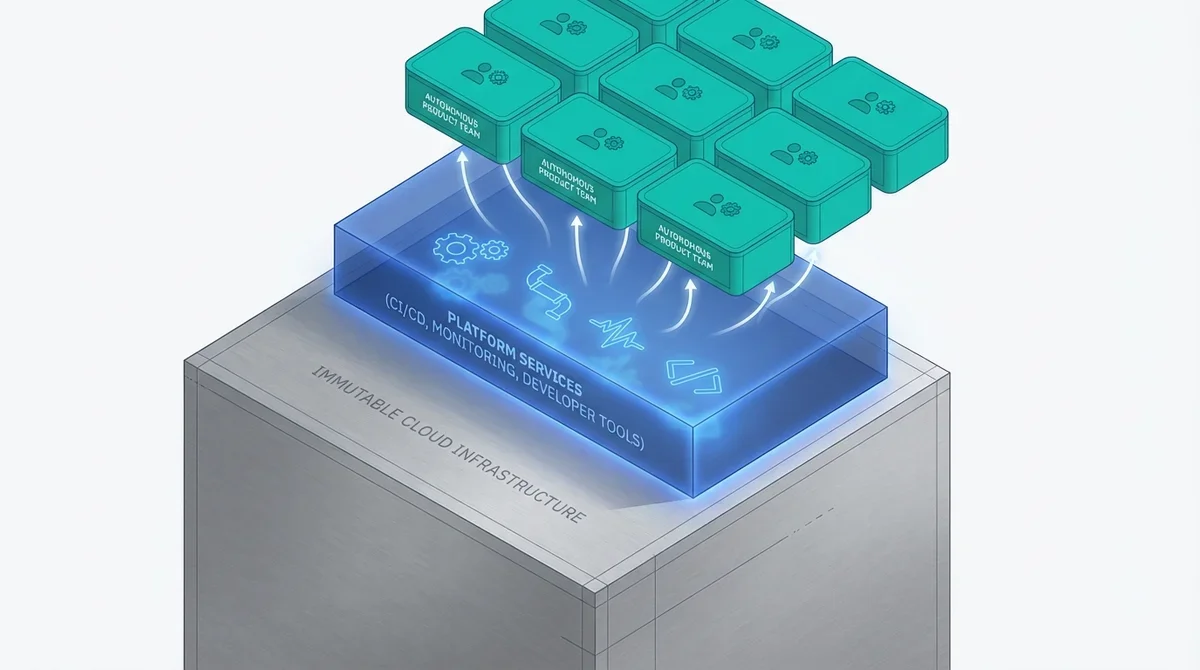
Dans les organisations qui grandissent, les développeurs commencent à passer une part croissante de leur temps sur des problèmes qui n’ont rien à voir avec le produit : pipelines fragiles, environnements incohérents, mises en production qui exigent des connaissances ésotériques. La réponse instinctive consiste à créer une « équipe plateforme » chargée de tout cela.
C’est souvent la mauvaise réponse. Une équipe plateforme dédiée risque de devenir le nouveau goulot d’étranglement : l’ancienne équipe infrastructure, avec un nom plus moderne. Les équipes produit restent dépendantes, les demandes s’accumulent dans une file, et l’autonomie qu’on voulait créer devient une dépendance de plus à gérer.
Le platform engineering, quand il fonctionne, est un ensemble de pratiques et d’outils partagés qui rendent chaque équipe autonome dans sa livraison.
L’anti-pattern de l’équipe plateforme
Le scénario se répète. L’organisation grandit, les problèmes d’infrastructure se multiplient, quelqu’un propose de créer une équipe dédiée. L’équipe plateforme naît avec de bonnes intentions : standardiser, automatiser, simplifier. Mais en quelques mois, un schéma prévisible s’installe :
- Les équipes produit arrêtent de s’occuper des outils communs parce qu’« il y a l’équipe plateforme pour ça »
- Chaque demande passe par l’équipe plateforme, qui devient un goulot d’étranglement
- Les priorités de l’équipe plateforme ne correspondent plus à celles des équipes produit
- La connaissance de l’infrastructure se concentre sur quelques personnes ; le reste de l’organisation perd en compétence
- Quand l’équipe plateforme est surchargée, les équipes produit attendent
Le résultat est paradoxal : on a créé une équipe pour donner de l’autonomie, et on a obtenu une nouvelle dépendance. C’est le même mécanisme qui produit les dépendances entre équipes : chaque point de centralisation devient un point de ralentissement.
La plateforme comme pratique partagée
L’alternative consiste à voir la plateforme comme un ensemble de pratiques partagées que toutes les équipes connaissent, utilisent et aident à faire évoluer.
Concrètement :
- La pipeline CI/CD est la responsabilité de tous : chaque équipe sait comment elle fonctionne, peut l’adapter à ses besoins et contribue aux améliorations ; personne ne la gère comme une boîte noire. Quand le CI/CD est réel, chaque développeur le comprend et se l’approprie
- L’infrastructure as code vit dans le dépôt de tout le monde : les environnements sont définis en code, versionnés, reproductibles. Chaque équipe peut créer, modifier et détruire ses propres environnements sans demander la permission à personne
- L’observabilité est une compétence partagée : aucune équipe ne surveille pour le compte des autres. Chaque équipe sait lire ses propres logs, ses propres métriques, ses propres alertes. Le débogage est une compétence répandue dans toute l’équipe
- Les golden paths émergent du terrain : les bonnes pratiques circulent entre équipes du bas vers le haut. Quand une équipe résout un problème avec efficacité, cette solution devient le nouveau standard par adoption spontanée
Si une seule équipe sait livrer en production, ce que vous avez est une dépendance déguisée en plateforme.
Quand la centralisation a du sens
Cela ne veut pas dire qu’un rôle dédié à la plateforme est toujours une erreur. Au-delà d’une certaine échelle (30 à 40 développeurs), la complexité infrastructurelle peut justifier des personnes dédiées. La différence tient au mandat.
Une équipe plateforme qui fonctionne opère comme un enabling team : elle accompagne les équipes produit, transfère des compétences, construit des outils que d’autres possèdent ensuite. Elle permet aux autres de posséder l’infrastructure, sans la posséder elle-même.
Les signes qu’une centralisation fonctionne :
- Les équipes produit livrent plus vite qu’avant, en autonomie
- Les demandes à l’équipe plateforme diminuent dans le temps, à mesure que les équipes deviennent autonomes
- La connaissance de l’infrastructure est distribuée : si l’équipe plateforme part en vacances, rien ne s’arrête
Les signes qu’elle vire à l’anti-pattern :
- Les demandes à l’équipe plateforme augmentent dans le temps
- Les équipes produit ont arrêté de comprendre comment fonctionnent la pipeline et l’infrastructure
- L’équipe plateforme a un backlog de plusieurs semaines, et tout le monde attend
L’impact sur l’activité
Bien fait, le platform engineering a un effet multiplicateur. Chaque amélioration de la plateforme se multiplie par le nombre d’équipes qui en bénéficient. Une pipeline plus rapide de 5 minutes, multipliée par 10 mises en production par jour sur 5 équipes, représente une économie significative chaque semaine.
Les indicateurs qui comptent sont avant tout des indicateurs d’activité :
- Temps entre le commit et la production : c’est la mesure la plus directe de l’efficacité de la plateforme. Si elle baisse, la plateforme fonctionne
- Temps d’onboarding : combien de temps faut-il à un nouveau développeur pour faire sa première mise en production ? Une plateforme efficace fait passer ce délai de semaines à quelques jours
- Part du temps consacrée aux problèmes d’infrastructure : si les équipes passent 30 % de leur temps sur le tooling et l’infrastructure, il y a un problème. L’objectif se situe sous les 10 %
Ce qu’il faut faire concrètement
Trois actions pour commencer sans créer d’équipe dédiée :
Dans les organisations que nous accompagnons dans le cadre de nos Équipes intégrées, l’équipe plateforme centralisée naît presque toujours d’une frustration bien réelle : chaque équipe a sa propre pipeline, sa propre façon de déployer, son propre setup d’environnement. La réponse évidente, c’est de centraliser. Le résultat, presque invariablement, c’est un nouveau goulot d’étranglement : chaque demande d’infrastructure devient un ticket en attente. L’alternative qui fonctionne, et que nous voyons fonctionner, c’est de construire des outils en self-service si bons que les équipes n’ont plus besoin de demander. La différence tient à un choix : qui sert qui.
- Rendez la pipeline compréhensible par tous : si seulement deux personnes dans l’organisation savent comment elle fonctionne, c’est un risque. Documentez, simplifiez, et assurez-vous que chaque développeur puisse la lire, la comprendre et la modifier
- Standardisez un golden path : choisissez l’opération que chaque équipe réalise différemment (créer un environnement, configurer le monitoring, lancer un nouveau service) et définissez un parcours standard, construit avec les équipes, qu’elles adoptent parce qu’il fonctionne vraiment
- Mesurez le temps perdu : pendant une semaine, suivez combien de temps chaque équipe consacre aux problèmes de tooling, de pipeline, d’environnements. Au-delà de 20 %, les pratiques de plateforme sont le meilleur investissement possible
La plateforme est un investissement stratégique sur l’autonomie de l’organisation. Chaque compétence transférée aux équipes, c’est une dépendance en moins. Chaque outil partagé que tout le monde sait utiliser, c’est un goulot d’étranglement éliminé.
Si votre organisation a grandi et que les équipes ont perdu leur autonomie de livraison, les pratiques de plateforme se construisent en travaillant avec les équipes : c’est le type de transfert que nous menons avec les Équipes intégrées.