Toute scale-up atteint un point où le monolithe commence à freiner. Les fonctionnalités s’accumulent, les mises en production deviennent risquées, les équipes se marchent sur les pieds. La tentation est forte : « passons aux microservices, et tout sera réglé ».
Pour être honnête, les microservices résolvent des problèmes d’échelle organisationnelle, bien plus que des problèmes d’échelle technique. Si votre équipe n’arrive pas à livrer de façon indépendante sur le monolithe, elle n’y arrivera pas mieux avec des microservices : elle aura simplement plus de services à coordonner. La migration a du sens quand les frontières du domaine sont claires, que les équipes peuvent travailler en parallèle sans interférences, et que le monolithe est le vrai goulot d’étranglement. Pas avant.
Cet article est une roadmap pratique pour qui envisage une migration : quand elle a du sens, quand elle n’en a pas, et comment la mener sans paralyser la livraison.
Le monolithe n’est pas l’ennemi
Un monolithe bien structuré, avec des frontières internes claires, des modules indépendants et une pipeline de mise en production efficace, peut porter une organisation pendant des années. Des entreprises avec des dizaines de développeurs travaillent efficacement sur des monolithes : la clé tient à la qualité des frontières, quelle que soit la topologie architecturale choisie.
Le problème survient quand le monolithe devient un monolithe couplé : chaque modification touche des composants sans lien entre eux, chaque mise en production exige la coordination de plusieurs équipes, chaque test demande tout le système. À ce stade, c’est le couplage interne qui freine la livraison. Le choix d’être resté sur un monolithe n’y est pour rien.
Avant de décider de migrer, posez-vous la bonne question : « les frontières de notre système sont-elles au bon endroit ? »
Quand les microservices résolvent le problème
Les microservices sont la bonne réponse quand le problème est structurel. Trois signaux qui indiquent qu’une migration a du sens :
- Des équipes bloquées par les dépendances : les équipes n’arrivent pas à livrer en autonomie parce que chaque changement traverse des frontières de responsabilité. La coordination entre équipes devient le principal goulot d’étranglement (pour aller plus loin sur les dépendances entre équipes)
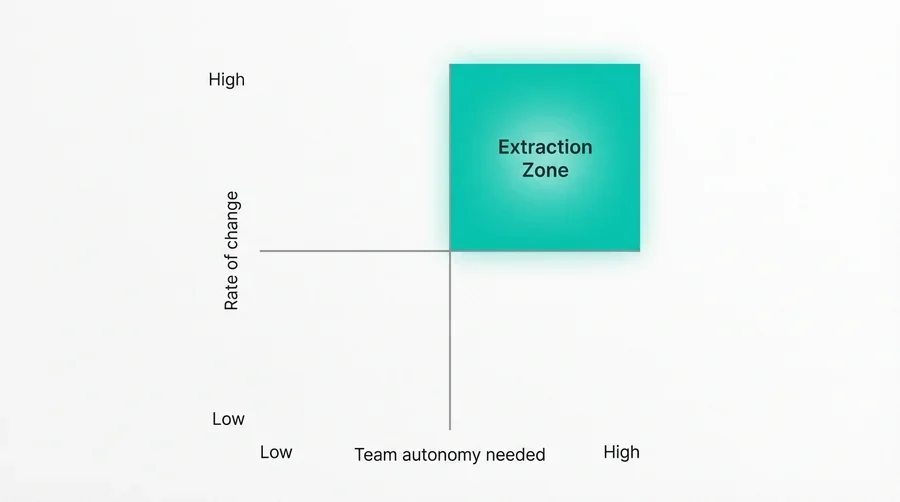
- Des parties du système qui changent à des vitesses différentes : le module paiements change chaque semaine, le module reporting chaque trimestre. Les livrer ensemble gaspille du temps et ajoute du risque
- Un besoin de scalabilité sélective : une partie du système exige dix fois plus de ressources de calcul que le reste. Faire monter en charge tout le monolithe pour une seule fonctionnalité coûte cher et reste inefficace
Si aucun de ces signaux n’est présent, le problème se règle probablement avec un refactoring stratégique interne au monolithe : moins risqué, moins coûteux et plus rapide.
Quand les microservices aggravent les choses
Les microservices ne sont pas gratuits. Chaque service extrait ajoute de la complexité opérationnelle : surveillance, déploiement, réseau, gestion des erreurs distribuées, cohérence des données. Si l’organisation n’est pas prête à gérer cette complexité, le résultat est un monolithe distribué : tous les inconvénients du monolithe, plus tous ceux des systèmes distribués.
Les signes qu’une migration est prématurée :
- L’équipe n’a pas d’expérience des systèmes distribués
- Il n’existe pas de pipeline CI/CD automatisée et fiable
- La surveillance en production est absente ou rudimentaire
- Les frontières du domaine ne sont pas claires : personne ne sait où finit un module et où commence l’autre
- Le problème se résout en travaillant sur la qualité du code, sans toucher à l’architecture
Dans ces cas, la priorité est de consolider les fondations : tests, CI/CD, surveillance, responsabilité des modules. Ce n’est que lorsque ces bases sont solides que la migration devient une option viable.
La roadmap : comment migrer de façon incrémentale
La migration vers les microservices est un parcours incrémental, sans big-bang, qui se mesure en mois, parfois en années, et qui produit de la valeur à chaque étape.
Étape 1 : cartographier les frontières du domaine. Avant d’extraire quoi que ce soit, il faut comprendre où se situent les frontières naturelles du métier. Des techniques comme l’Event Storming ou le Domain Storytelling aident à faire émerger les bounded contexts : les zones du système qui devraient pouvoir évoluer indépendamment. Cette carte guide toutes les décisions suivantes.
Étape 2 : identifier le bon candidat. Extraire le module qui offre le meilleur rapport entre friction actuelle et risque d’extraction, indépendamment de sa taille ou de son importance. C’est en général un module qui change souvent, dont les frontières sont relativement claires et qui ne se trouve pas au centre de trop de dépendances.
Étape 3 : isoler la frontière. Avant d’extraire le module, définir l’interface entre lui et le reste du système. Cette frontière, le fameux anti-corruption layer, est le contrat qui permet à l’ancien et au nouveau de cohabiter. Le monolithe appelle le nouveau service à travers cette interface ; si le nouveau service tombe en panne, l’ancien code peut encore répondre.
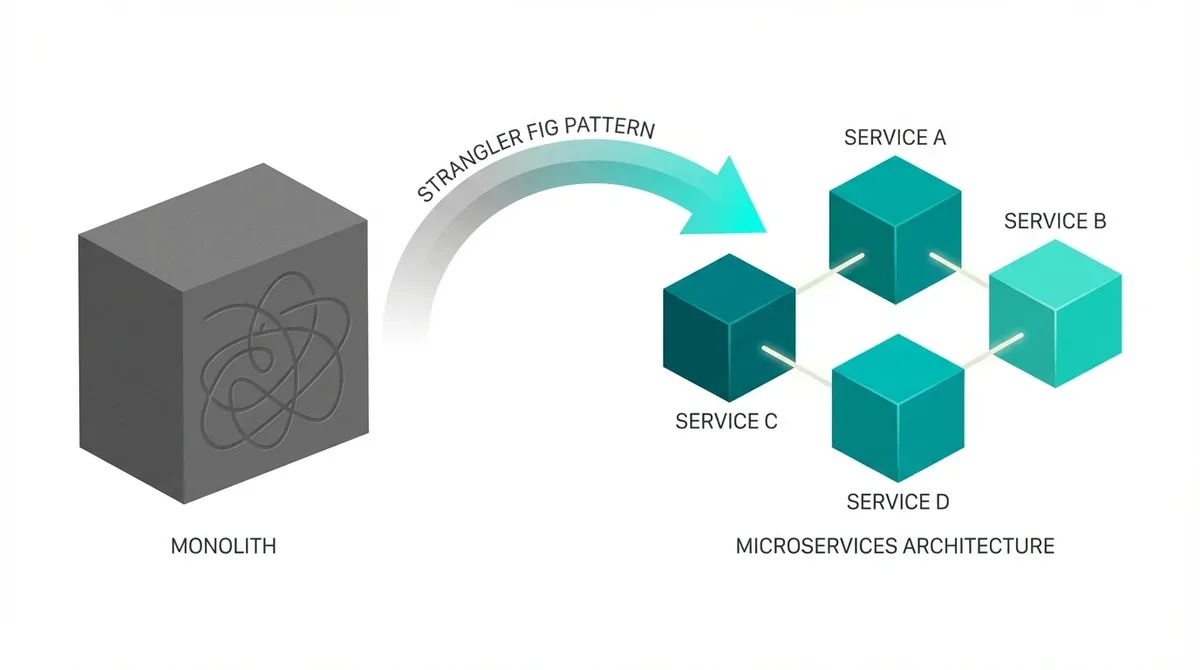
Étape 4 : migrer progressivement. C’est le pattern Strangler Fig : le nouveau service gère une part croissante du trafic pendant que l’ancien code est progressivement retiré. La transition reste contrôlée et réversible, sans grand basculement.
Étape 5 : valider et recommencer. Après chaque extraction, mesurer l’impact : l’équipe livre-t-elle plus vite ? Les dépendances ont-elles diminué ? Le système est-il plus stable ? Si oui, passer au candidat suivant. Si non, comprendre ce qui a mal tourné avant de continuer.
L’erreur la plus fréquente : de mauvaises frontières
Le plus grand risque d’une migration est conceptuel. Le risque technique pèse beaucoup moins. Si les frontières entre services ne reflètent pas les frontières du domaine métier, le résultat est un système distribué où chaque fonctionnalité exige des appels à cinq services différents, où les transactions deviennent distribuées et où le débogage tourne au cauchemar.
Les frontières architecturales doivent suivre les frontières organisationnelles. Chaque service devrait appartenir à une seule équipe ; chaque équipe devrait pouvoir livrer son propre service sans coordination avec les autres. Si ce n’est pas possible, les frontières sont au mauvais endroit.
C’est la loi de Conway à l’œuvre : la structure du logiciel reflète la structure de l’organisation. Redessiner l’architecture sans redessiner l’organisation ne produit que des résultats temporaires ; en quelques mois, le système recommence à refléter l’ancienne structure. Nous en parlons en détail dans l’article sur l’architecture évolutive.
Ce qu’il faut faire concrètement
Si vous envisagez une migration, voici les trois actions à mener avant d’écrire la moindre ligne de code :
L’erreur qu’on voit le plus souvent chez les scale-up qui nous contactent pour une migration, c’est celle-ci : elles veulent passer aux microservices parce que « le monolithe est devenu difficile à gérer », mais quand on analyse le système, on découvre que le vrai problème tient à l’absence de frontières claires entre les modules. Le choix de rester sur un monolithe n’y joue qu’un rôle marginal. Un monolithe modulaire, avec une responsabilité claire par domaine, règle 70 % des problèmes de coordination qu’on attribue à l’architecture monolithique. La migration vers les microservices vient ensuite, si et quand elle est vraiment nécessaire.
- Cartographiez les dépendances réelles, celles qui ressortent du code et des échanges entre équipes. Qui parle à qui ? Quel module change chaque fois qu’un autre change ? Le Consistency Impact Calculator peut vous aider à chiffrer la friction
- Validez les frontières avec le métier : les frontières techniques doivent refléter les frontières du domaine. Si l’équipe paiements et l’équipe commandes travaillent sur le même module, la frontière est au mauvais endroit
- Commencez par le module le moins risqué, en gardant le plus critique pour plus tard. Le premier service extrait est celui où vous apprenez le processus ; le deuxième est celui où vous créez de la valeur
Si le tableau est complexe, si les dépendances sont emmêlées et les frontières floues : c’est exactement le type de situation où une intervention ciblée fait la différence. Trouver le bon point de départ est souvent la décision la plus importante de tout le parcours. Quand la friction est au contraire diffuse dans tout le système, rendre le monolithe modulaire avant de le découper fait partie du refactoring du code legacy.